La mayoría de los investigadores utilizan un modelo de lenguaje grande como si fuera un motor de búsqueda mejorado: formulan una pregunta, obtienen una respuesta más o menos aceptable y, a continuación, dedican una cantidad considerable de tiempo a editarla hasta que cumpla con los estándares. Al día siguiente surge un problema similar y el proceso vuelve a empezar desde cero. Lo que cambia esta situación no es una pregunta mejor formulada, sino asignarle al modelo una tarea diferente: no responder a preguntas sobre tu trabajo, sino llevar a cabo una parte concreta del mismo. Esto ocurre en tus propias carpetas, con tus propios datos, dentro de las reglas que tú estableces y con controles que puedes verificar tú mismo, y que se ejecutan cada vez. Esa es la diferencia entre una respuesta y un resultado que puedes utilizar en tu flujo de trabajo.
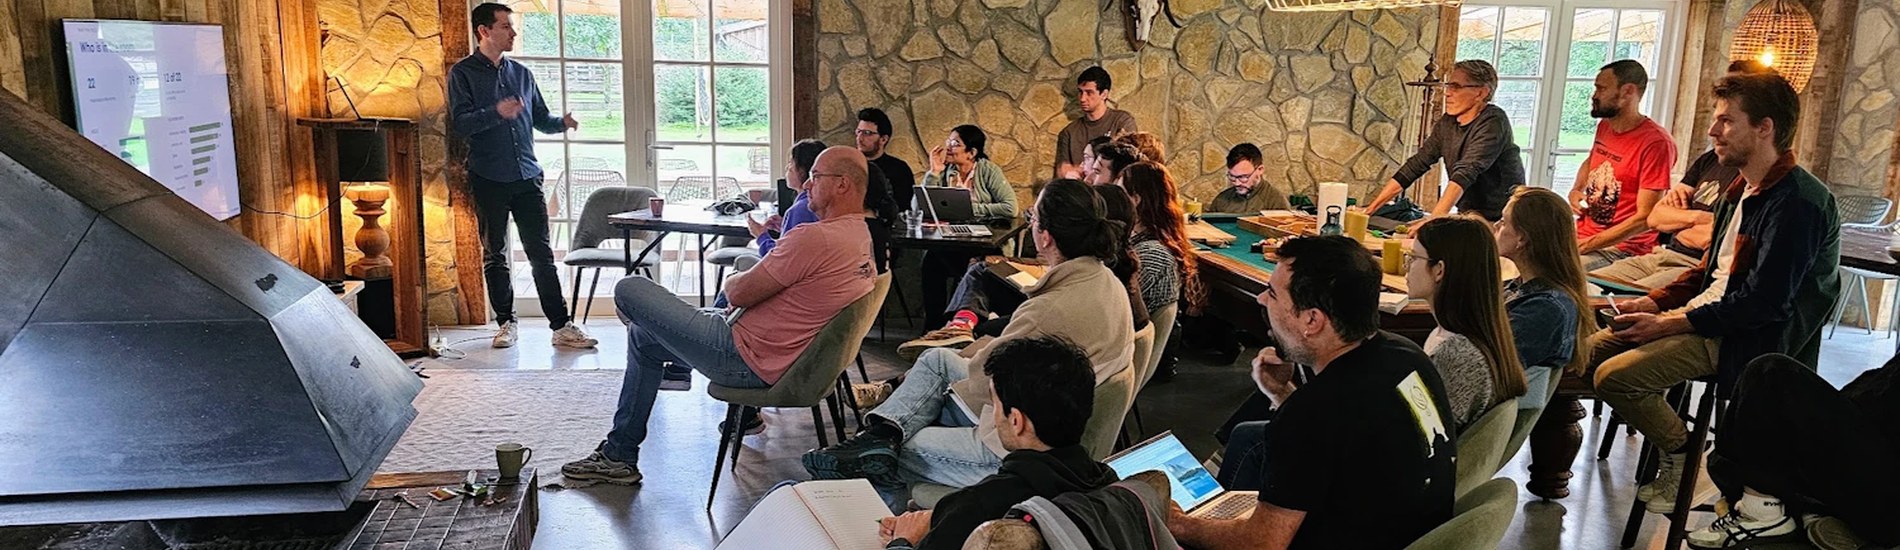
Esto es lo que FutureWater enseñó a los investigadores del grupo Kops del Instituto Hubrecht el 17 de septiembre, en un taller de medio día diseñado a medida durante el retiro del grupo. Cada participante trabajó en una tarea de su propia investigación. Un investigador creó un complemento de procesamiento de imágenes para acelerar el análisis de imágenes. El coordinador de microscopía del grupo estableció un flujo paso a paso para gestionar los errores del microscopio, de modo que los compañeros puedan resolver por sí mismos los problemas habituales. Otros trabajaron en una revisión bibliográfica que examina los artículos y comprueba todas las fuentes que citan, en un manuscrito redactado según las normas de la revista a la que se dirige y en un protocolo de laboratorio convertido en un plan de proyecto.
Posteriormente, los 14 participantes que rellenaron el formulario de comentarios afirmaron que es probable que utilicen Claude en su propio trabajo durante el próximo mes; 12 de ellos, muy probablemente. Lee más sobre la formación en nuestra página del proyecto.